
 用观猹登录
社会影响:排行榜也在制造热门
MusicLab 音乐市场实验:让人看见别人下载了什么,成功更不均,也更难预测
洛洛做小红书最想不通的,是有两条笔记的命完全不一样:同一个选题,同一套封面模板,文案结构几乎照抄,一条三千赞,一条两百赞。
复盘那天洛洛列了满满一页原因:这条留白多、那条首图字太小……越列越觉得自己找到了规律。然后把这页发给默子老师,他问了一句:"你确定这些差别加起来能解释十五倍吗?"
洛洛当场没话说。后来读到这个实验心情更复杂了——有一部分差距,可能真的没有原因。 不是你没找到,是它本来就不存在,早期几个人的随机点击被放大成了后面的全部差距。
研究说了什么
先说这个实验最狠的地方:它把同一段历史平行地跑了八遍。
2006 年,Matthew Salganik、Peter Dodds 和 Duncan Watts 在《Science》上发表了后来被叫作 MusicLab 的实验。他们造了一个人工音乐市场:14341 名参与者面对 48 首没听过的歌,可以试听、打分、决定下不下载。人被随机分到两种条件:
- 独立条件:只看到歌名和乐队名,不知道别人下载了什么。
- 社会影响条件:还能看到每首歌已经被下载了多少次。
关键设计在这里:社会影响条件下的参与者又被随机分进 8 个互相独立的"世界",每个世界只统计自己内部的下载量。同一批歌、同样的零起点,跑八遍。
论文还做了第二个实验加强社会信号:实验一里歌曲随机排成 16 乘 3 的网格,实验二里按下载量从高到低排成一列——也就是做成了排行榜。
结果有三条:
- 不均程度上升。 用基尼系数衡量,两个实验里 8 个社会影响世界全部比独立世界更不均。
- 信号越强,越不均。 从网格换成排行榜,不均程度进一步上升。
- 不可预测性上升。 同一首歌在 8 个平行世界里的名次差得很远,实验二比实验一差得更远。
论文摘要那句洛洛抄进了备忘录:成功只有一部分由质量决定——最好的歌很少垫底,最差的歌很少夺冠,但除此之外,什么结果都可能发生。
为什么会这样
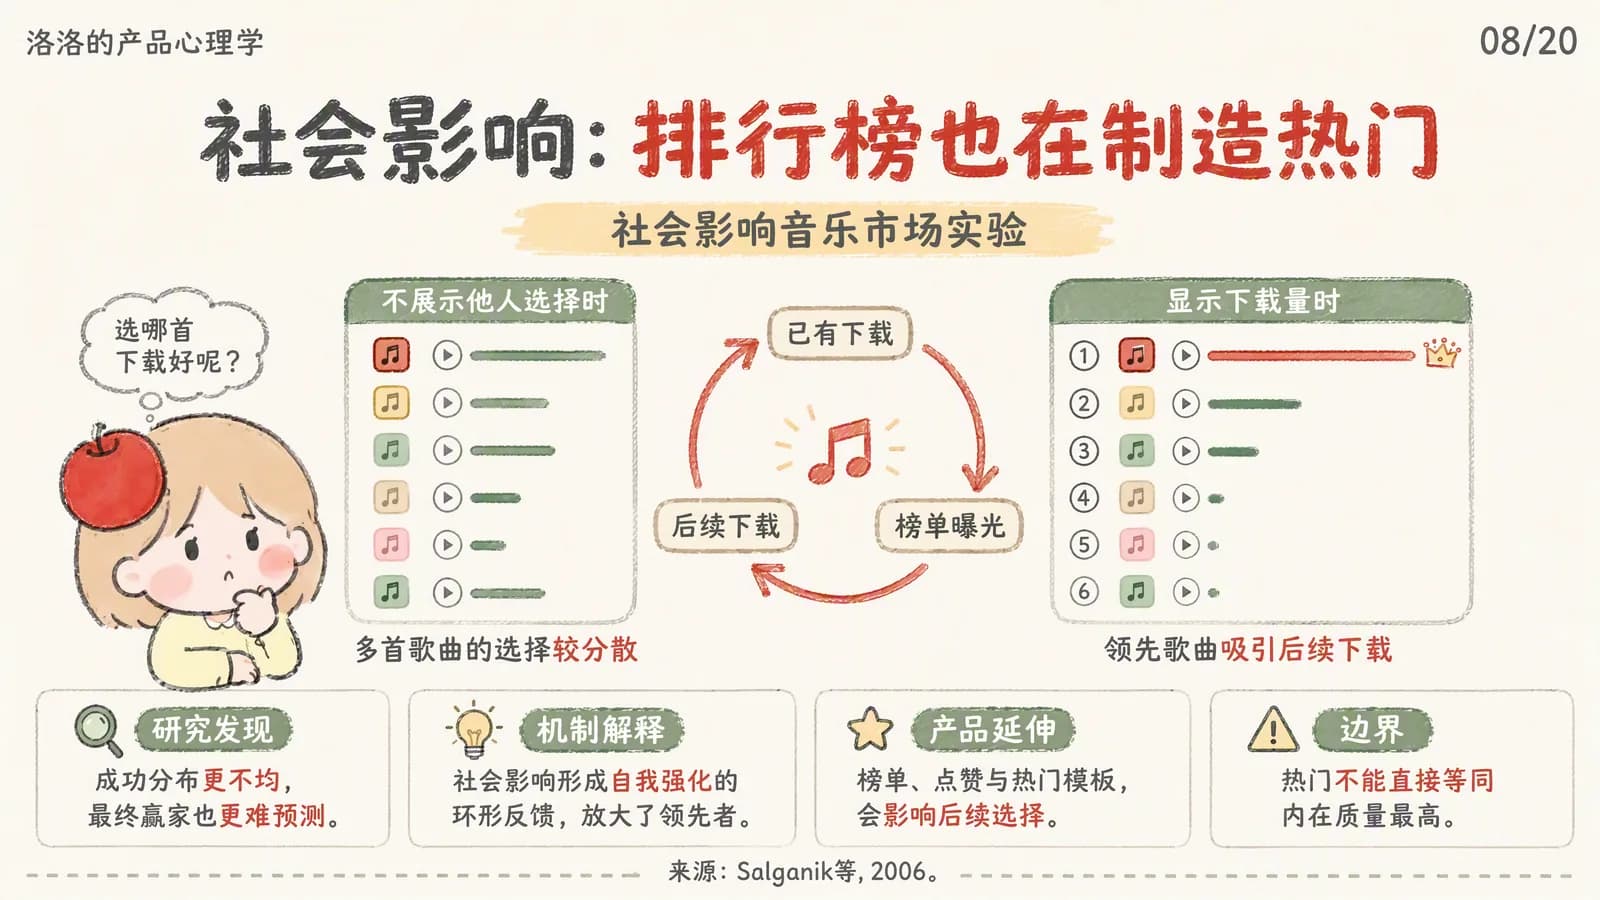
因为社会信息会自我强化。图中间那个圆环就是它:已有下载 → 榜单曝光 → 后续下载 → 曝光更靠前。
循环的起点往往非常小。前几十个人的选择带着大量随机性——谁先点了哪一首,可能只因为鼠标离得近。但某首歌一旦领先就会出现在更多人眼前,领先被锁住。等第一万个人进来时,他看到的榜单已经跟质量没多大关系了。
最反直觉的是第二条:信号越强,结果越不可预测。 洛洛看了半天才反应过来——直觉上"大家都在看的"应该更接近真实偏好,但实验说反了:排行榜越醒目,早期噪音被放大的倍数越大。
放到产品里怎么用
图上"产品延伸"写的是:榜单、点赞与热门模板会影响后续选择。
- 展不展示社会证据是产品决策,不是默认开关。 展示销量、点赞、下载量会把流量往头部推:你要"让好东西被更多人看到"它有用,你要"让长尾活下去"它会反着来。
- 给新内容留一个不靠榜单的入口。 洛洛做内容合集会固定留几个"随机推荐"位,相当于留一小块"独立条件"。
- 别把榜单当质量评估用。 选商品、选模板时热度只能当参考,判断质量得看完成率、复购、退货、评论内容。
洛洛碎碎念
读完论文那个晚上,洛洛把自己那页复盘删了一半。
那些"留白多两毫米"的解释被我写得像因果关系,其实只是在给随机性编故事。人很难接受"这次就是运气",宁可编一个自己能控制的原因出来。
默子老师听完说了句更扎心的:"知道有运气成分,不是让你躺平,是让你多发几条。"菜之,行吧,还是得干活。
边界:别用过头
图上"边界"这格只有一句:热门不能直接等同内在质量最高。
第一,方向不能反着推。 实验证明的是"社会影响让成功更不均、更难预测",不是"榜单上的都是垃圾"。论文说得很清楚,最好的歌很少表现很差——热门这个位置本身不构成质量证明而已。
第二,实验条件是特殊的。 48 首完全没人听过的歌、全部从零开始、参与者主要来自一个青少年网站,先验信息几乎为零。你的用户往往已经有品牌认知和朋友推荐,别把实验里的分岔幅度直接套过来。
第三,用过头会有代价。 头部越集中,新供给越难进来,池子越来越浅;用户几次发现"榜一其实不怎么样",会连带不信任榜单本身。刷量的动机也永远存在。
洛洛的结论是:社会证据是一面放大镜,不是一杆秤。 它能让已经发生的事变大,却测不出东西好不好。
参考来源
- Matthew J. Salganik, Peter Sheridan Dodds, Duncan J. Watts,《Experimental Study of Inequality and Unpredictability in an Artificial Cultural Market》,Science,2006 年,311 卷 5762 期,854–856 页。https://doi.org/10.1126/science.1121066 (查阅日期 2026-09-14)
- 论文全文 PDF(作者在普林斯顿大学的公开托管版本,含实验设计与基尼系数图):https://www.princeton.edu/~mjs3/salganik_dodds_watts06_full.pdf (查阅日期 2026-09-14)